Um PDF escaneado é só um conjunto de fotos de páginas de papel. Você vê as palavras, mas o computador não: o Ctrl+F não encontra nada e não dá para selecionar nem uma linha. O OCR, sigla em inglês para reconhecimento óptico de caracteres, lê a imagem, identifica cada caractere e coloca uma camada de texto oculta sobre cada página.
OCR de PDF
Arraste um PDF para aqui
PDF · até 100 MB por ficheiro
Os ficheiros são apagados após 2 horas. Pode apagá-los logo depois de descarregar.
O que o OCR acrescenta ao seu arquivo
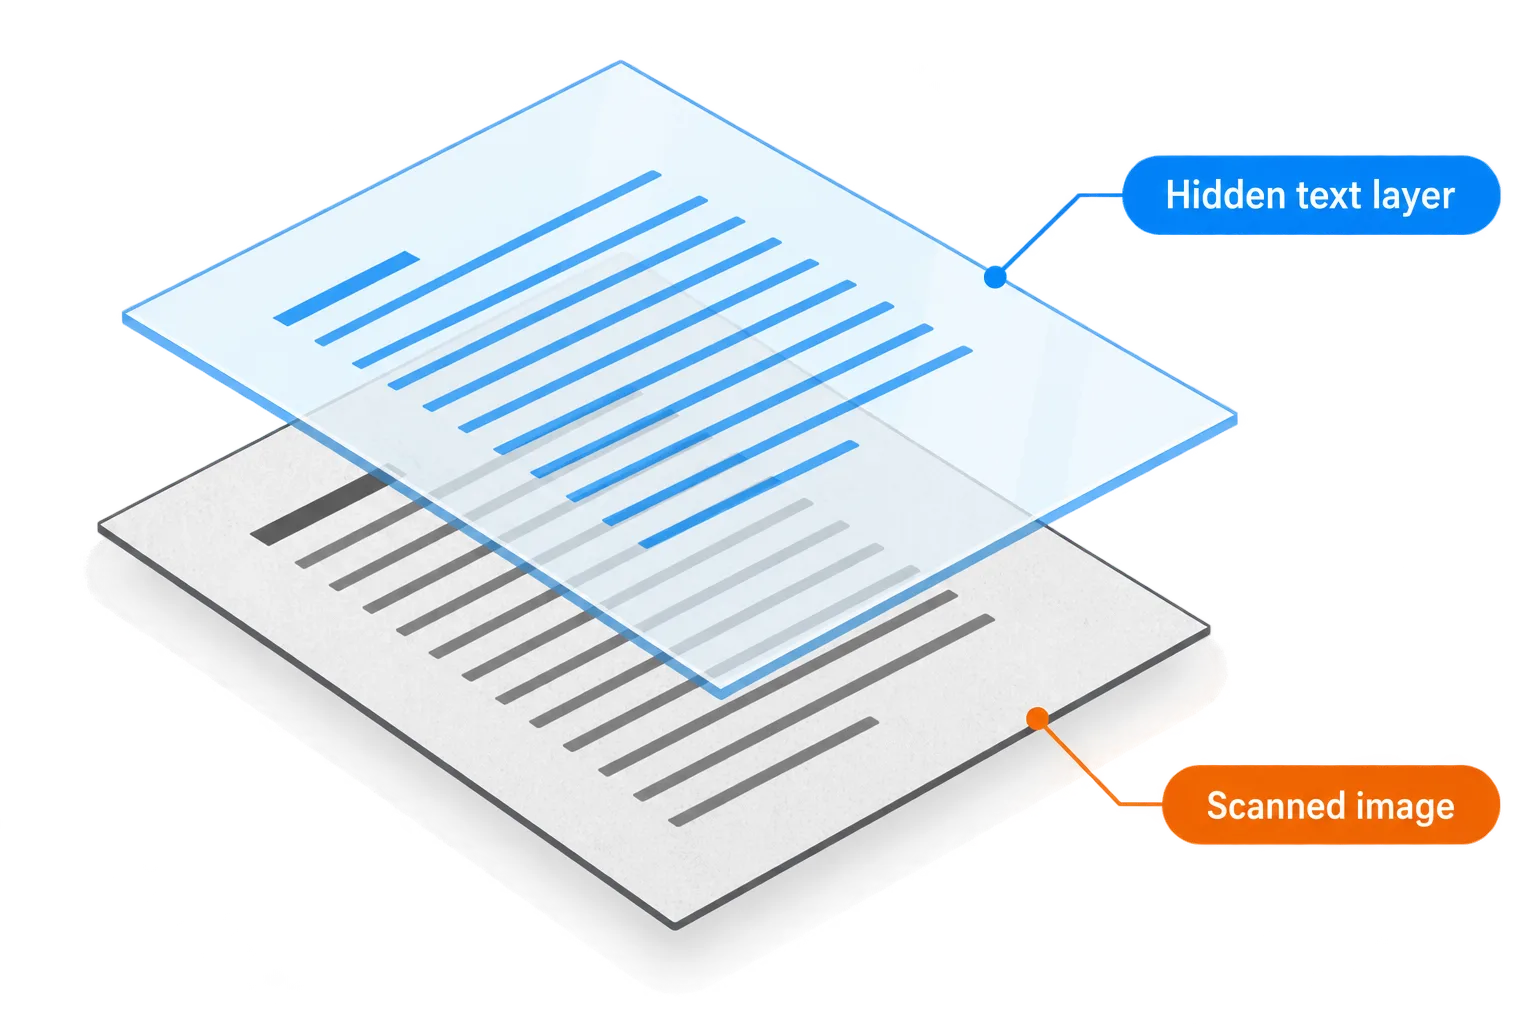
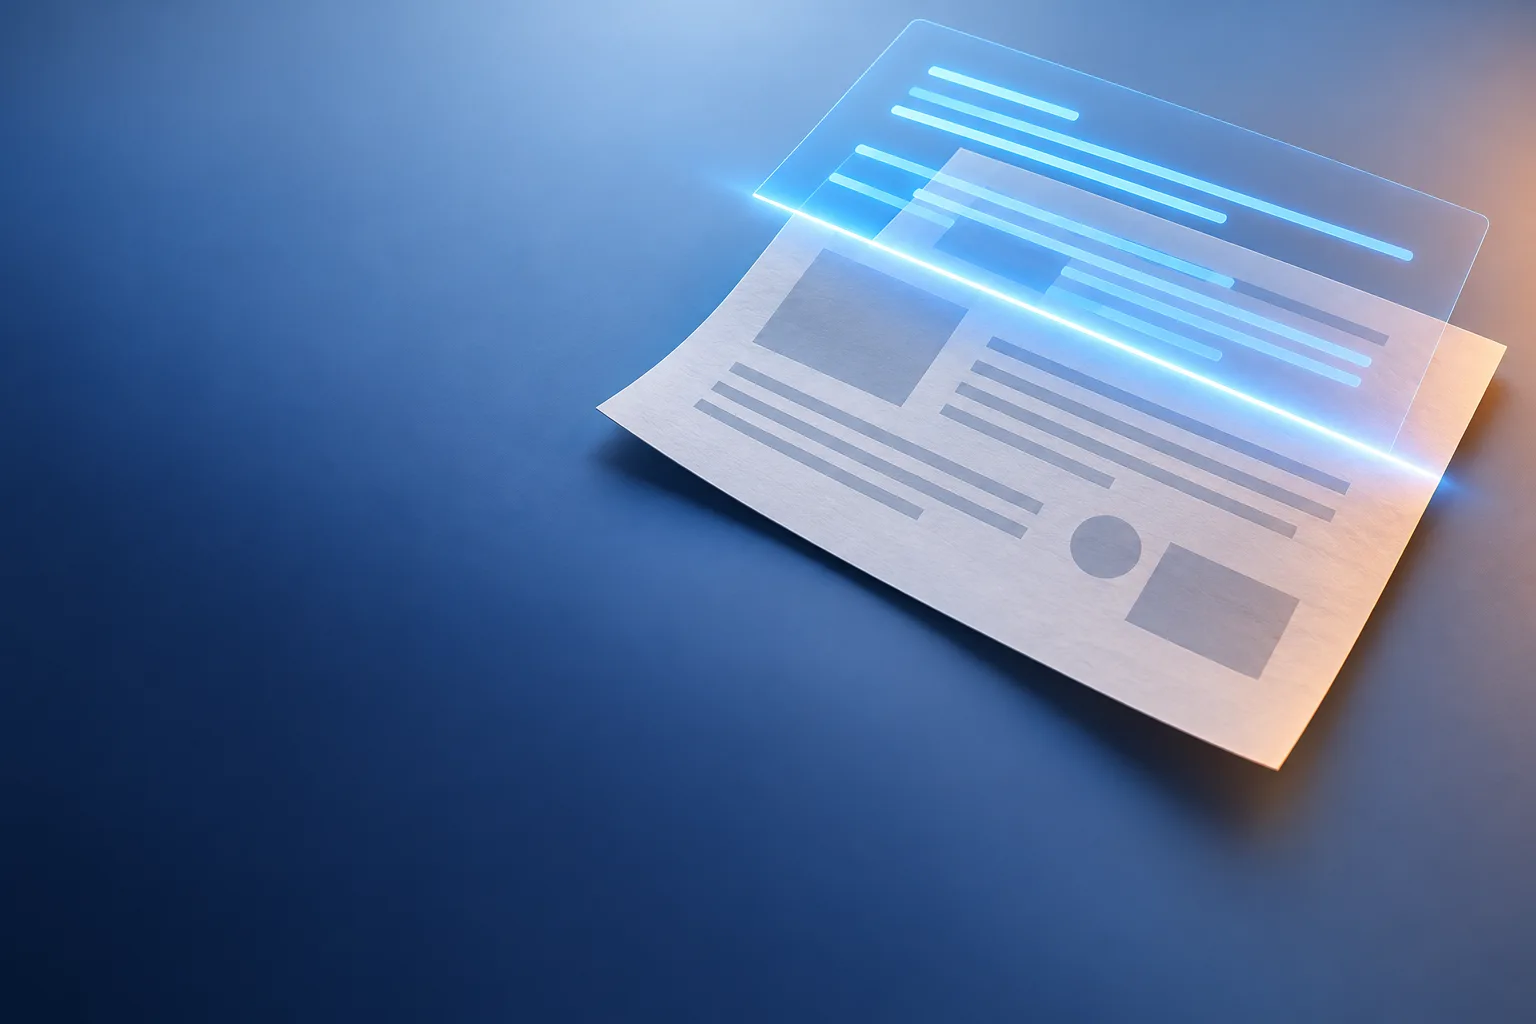
A imagem da página fica como está; uma camada de texto transparente fica sobre cada palavra.
Depois do OCR, a página fica exatamente igual ao documento escaneado, porque a imagem original continua no lugar. A novidade é uma camada transparente de texto alinhada sobre cada palavra da imagem. É nessa camada que você pesquisa, seleciona e copia, enquanto a impressão continua saindo com a página original.
É também por isso que os erros de OCR são difíceis de notar: a imagem mostra a palavra certa, enquanto a camada de texto por baixo pode dizer outra coisa.
Como digitalizar para o texto sair certo
| Fator | O ideal | Evite |
|---|---|---|
| Resolução | 300 DPI para texto de tamanho normal | Menos de 200 DPI, quando marcas pequenas e acentos somem |
| Alinhamento | Página reta, com as linhas niveladas | Páginas tortas, linhas curvadas perto da lombada de um livro |
| Luz | Uniforme e clara, texto escuro sobre fundo branco | Sombras, reflexos, papel muito escuro ou amarelado |
| Cor | Tons de cinza ou colorido, os dois funcionam | Compressão pesada antes do OCR |
Acentos, pingos e vírgulas têm só alguns pixels de altura. Em baixa resolução, um “e” e um “c”, ou um “5” e um “S”, começam a ficar parecidos, e os sinais diacríticos de idiomas como o vietnamita simplesmente desaparecem. Se você quer um OCR preciso, a resolução é onde mais vale a pena investir.
O celular também serve: coloque o papel bem plano e fotografe de cima, perto de uma janela. Junte as fotos com Imagem para PDF, depois clique em Continuar e escolha OCR de PDF.
Escolha o idioma certo
O padrão é Ambos, ou seja, vietnamita e inglês, o que serve para documentos bilíngues, como contratos. Se o documento usa só um idioma, escolha esse idioma: assim o mecanismo tem só um alfabeto para adivinhar e confunde menos caracteres.
Confira a camada de texto depois do OCR
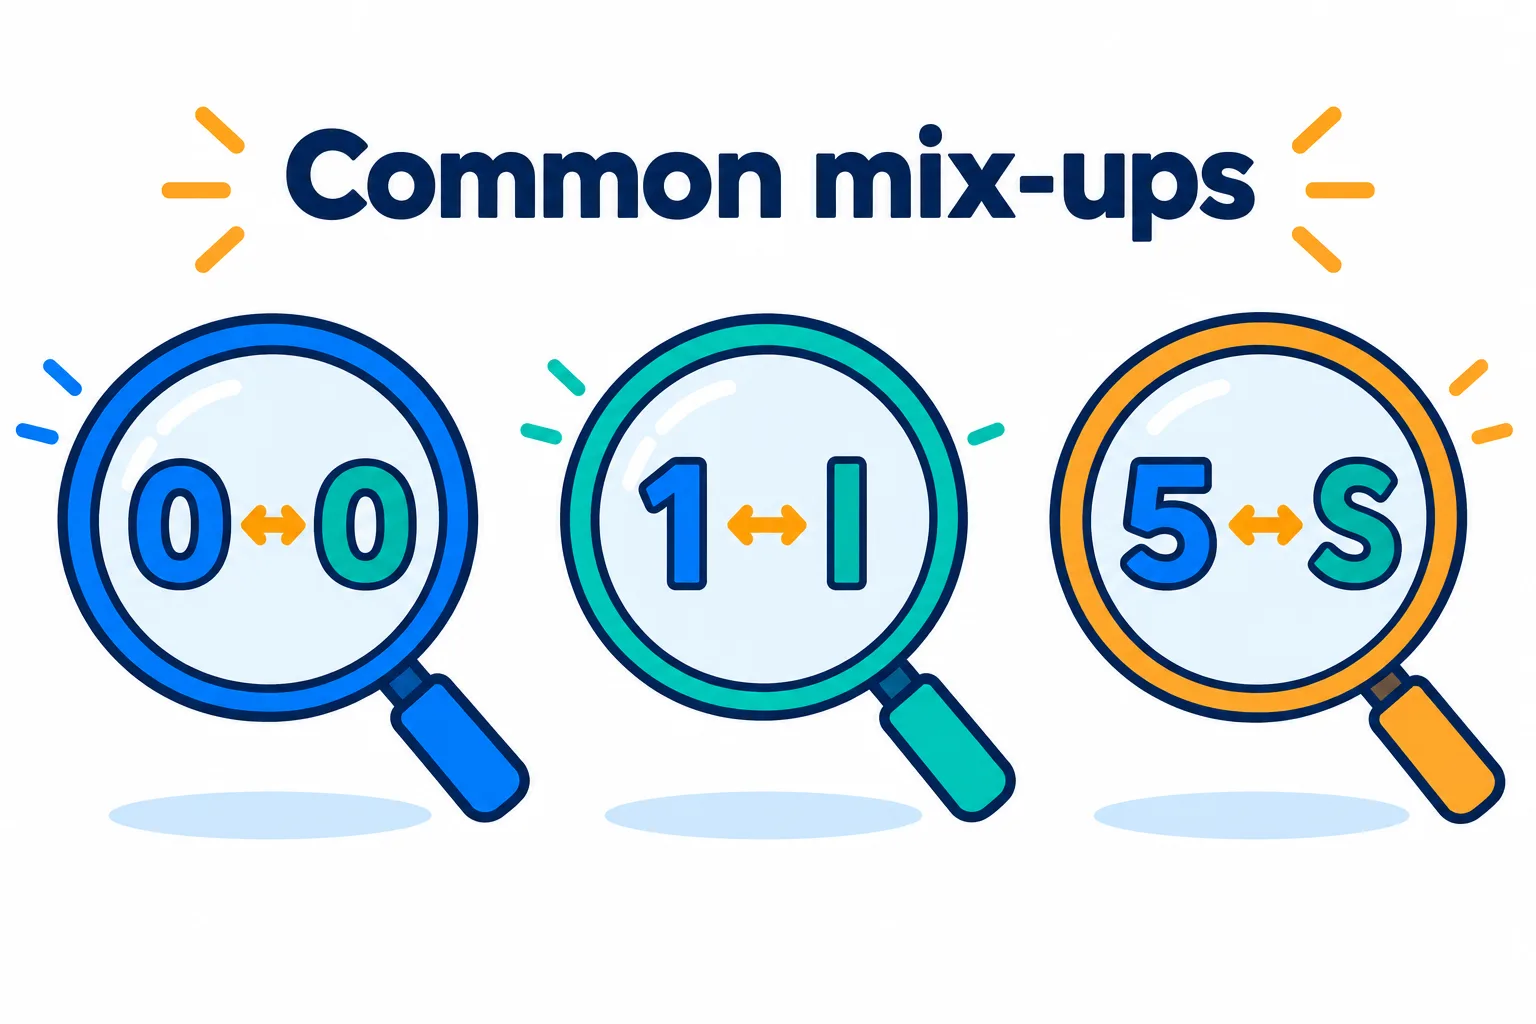
Esses pares são parecidos, então confira os números separadamente.
Passos
Pressione Ctrl+F e procure uma palavra que aparece várias vezes. Se todas as ocorrências forem encontradas, a camada de texto está em boas condições.
Selecione um parágrafo e cole em um editor de texto simples para ver o que a camada realmente diz.
Confira os números separadamente
0 e O, 1 e l, 5 e S são as confusões mais comuns.
Para editar o conteúdo, clique em Continuar e escolha PDF para Word.
Letra de mão, carimbos e assinaturas muitas vezes são lidos errado ou ignorados. Confira valores, números de contrato e datas com os próprios olhos antes de confiar neles.
Se o que você precisa mesmo é de um arquivo Word editável, veja como converter PDF para Word.
Perguntas frequentes
Como sei se um PDF precisa de OCR?
Tente selecionar uma linha. Se der para selecionar as palavras, o arquivo já tem texto e não precisa de OCR. Se não der, ou se a página inteira for selecionada como uma única imagem, é um documento escaneado.
Devo comprimir antes ou depois do OCR?
Depois. Comprimir antes deixa a imagem menos nítida e torna o OCR menos preciso. Faça o OCR no original e comprima depois, se o arquivo ficar pesado.
Qual é o nome do resultado?
O nome do seu arquivo com -ocr no final, então `carta.pdf` vira `carta-ocr.pdf`.
Meus arquivos ficam guardados no servidor?
Eles são excluídos após 2 horas, e você também pode apagá-los assim que tiver o resultado.
Experimente no seu ficheiro
Grátis e sem registo. Os ficheiros são apagados após 2 horas.