Zeskanowany PDF to tylko fotografie papierowych stron. Ty widzisz słowa, ale komputer nie: Ctrl+F niczego nie znajduje, a nie da się zaznaczyć ani jednego wiersza. OCR, czyli optyczne rozpoznawanie znaków, odczytuje obraz, rozpoznaje każdy znak i nakłada na każdą stronę ukrytą warstwę tekstu.
OCR w PDF
Przeciągnij plik PDF tutaj
PDF · do 100 MB na plik
Pliki są usuwane po 2 godzinach. Możesz je usunąć od razu po pobraniu.
Co OCR dodaje do pliku
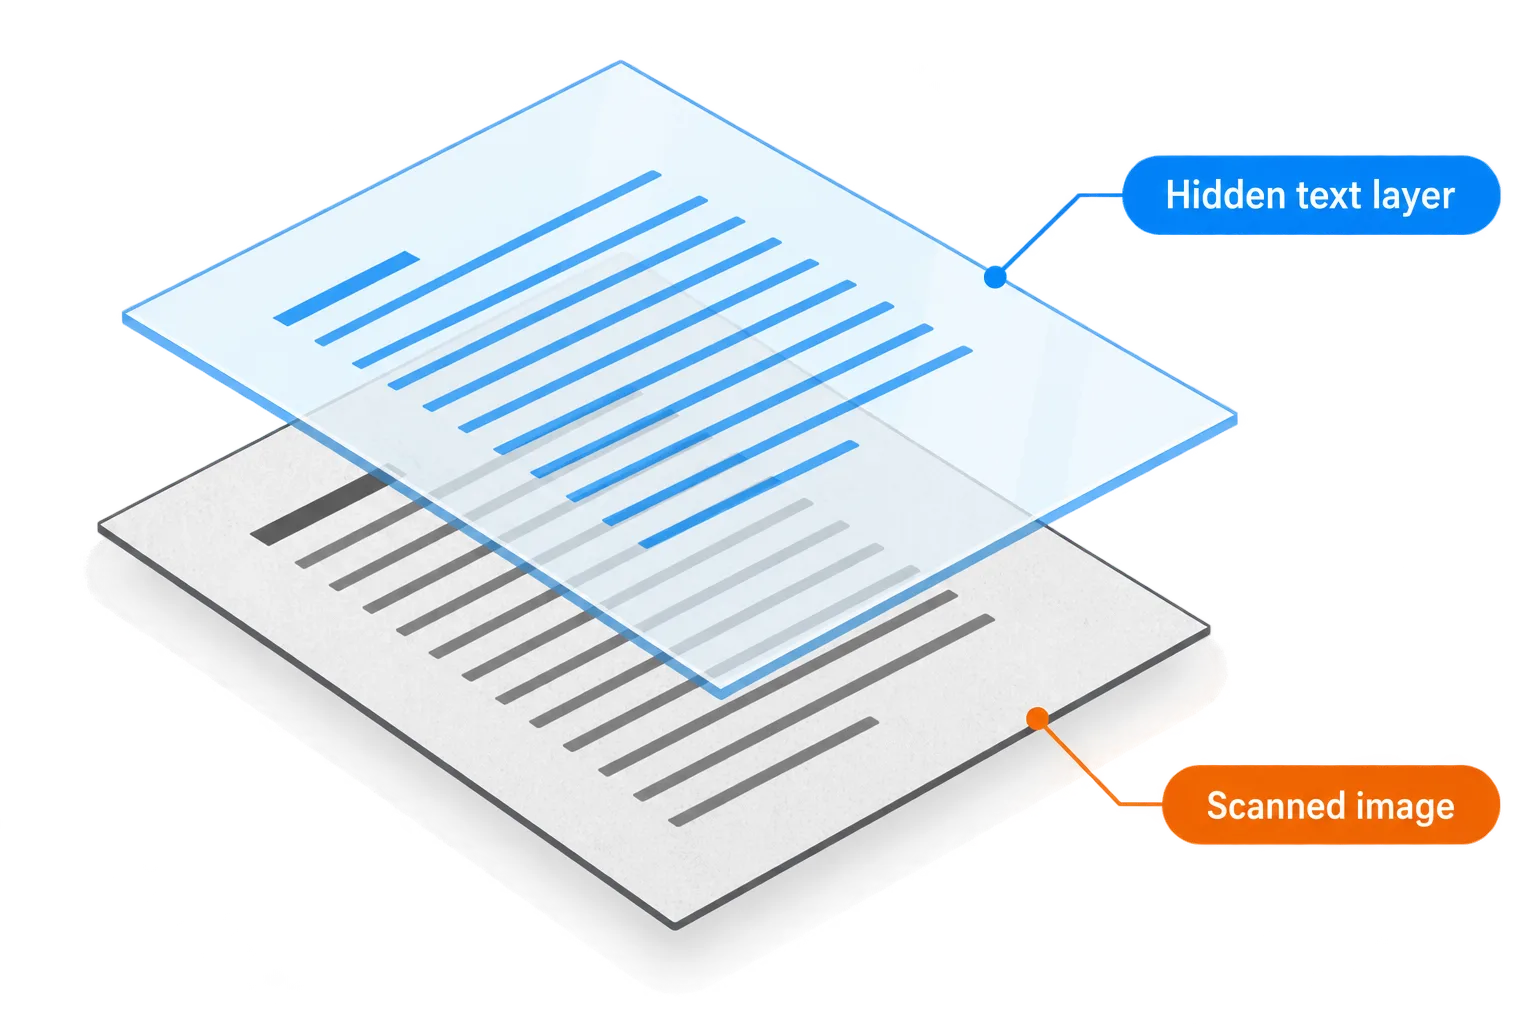
Obraz strony pozostaje bez zmian, a nad każdym słowem leży przezroczysta warstwa tekstu.
Po OCR strona wygląda dokładnie tak jak skan, bo oryginalny obraz zostaje na swoim miejscu. Nowością jest przezroczysta warstwa tekstu ułożona dokładnie nad każdym słowem na obrazie. To właśnie ją przeszukujesz, zaznaczasz i kopiujesz, a przy drukowaniu nadal otrzymujesz oryginalną stronę.
Z tego samego powodu błędy OCR trudno zauważyć: obraz pokazuje właściwe słowo, a warstwa tekstu pod spodem może zawierać coś zupełnie innego.
Jak skanować, by tekst został dobrze odczytany
| Czynnik | Do czego dążyć | Czego unikać |
|---|---|---|
| Rozdzielczość | 300 DPI dla tekstu o zwykłej wielkości | Poniżej 200 DPI drobne znaki i akcenty znikają |
| Ułożenie | Prosta strona z poziomymi wierszami | Przekrzywione strony, wiersze wygięte przy grzbiecie książki |
| Światło | Równomierne i jasne, ciemny tekst na białym tle | Cienie, odblaski, bardzo ciemny lub pożółkły papier |
| Kolor | Sprawdzą się zarówno odcienie szarości, jak i kolor | Mocna kompresja przed OCR |
Akcenty, kropki i przecinki mają zaledwie kilka pikseli wysokości. Przy niskiej rozdzielczości „e” i „c” albo „5” i „S” zaczynają wyglądać podobnie, a znaki diakrytyczne w językach takich jak wietnamski po prostu znikają. Jeśli zależy Ci na dokładnym OCR, najlepiej zadbać właśnie o rozdzielczość.
Telefon też się nada: połóż kartkę płasko i zrób zdjęcie prosto z góry przy oknie. Połącz zdjęcia narzędziem Obraz na PDF, a następnie kliknij Kontynuuj i wybierz OCR w PDF.
Wybierz właściwy język
Domyślnie ustawiona jest opcja Oba, czyli wietnamski i angielski, co pasuje do dokumentów dwujęzycznych, takich jak umowy. Jeśli dokument jest tylko w jednym języku, wybierz go: silnik ma wtedy do dyspozycji tylko jeden alfabet i rzadziej myli znaki.
Sprawdź warstwę tekstu po OCR
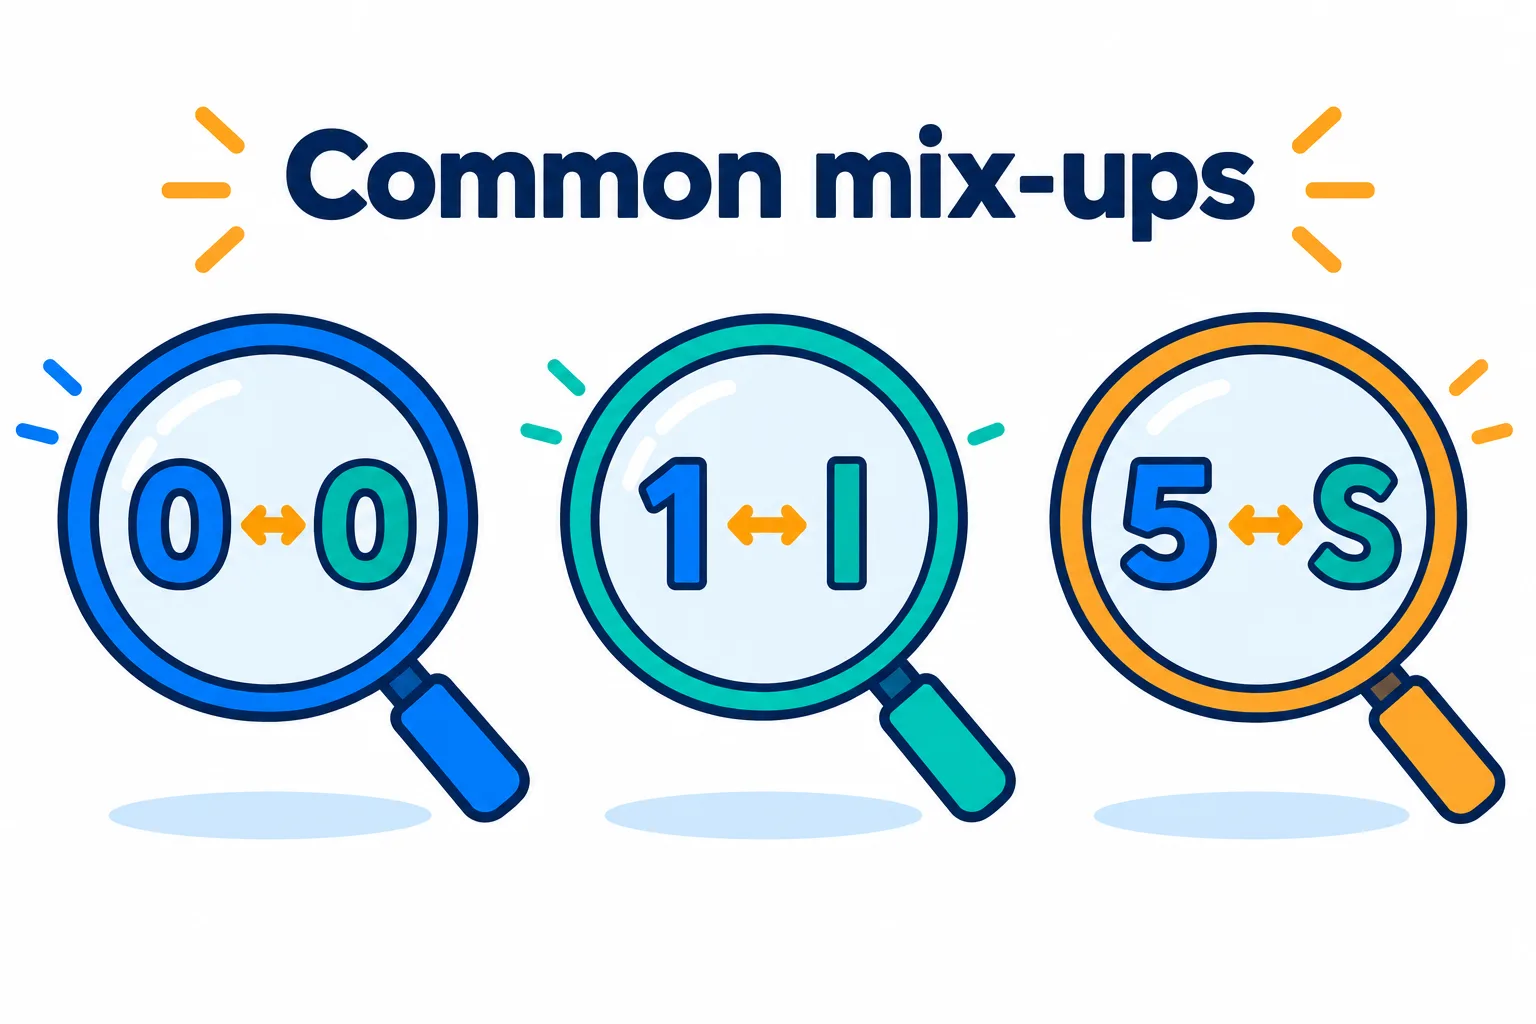
Te pary wyglądają podobnie, dlatego liczby sprawdzaj osobno.
Kroki
Naciśnij Ctrl+F i wyszukaj słowo, które występuje kilka razy. Jeśli zostaną znalezione wszystkie wystąpienia, warstwa tekstu jest w dobrym stanie.
Zaznacz akapit i wklej go do prostego edytora tekstu, aby zobaczyć, co naprawdę zawiera warstwa.
Sprawdź osobno liczby
najczęściej mylone są 0 i O, 1 i l oraz 5 i S.
Aby edytować treść, kliknij Kontynuuj i wybierz PDF na Word.
Pismo odręczne, pieczątki i podpisy są często odczytywane błędnie lub pomijane. Kwoty, numery umów i daty sprawdź na oko, zanim zaczniesz na nich polegać.
Jeśli tak naprawdę potrzebujesz edytowalnego pliku Word, zobacz, jak przekonwertować PDF na Word.
Częste pytania
Jak sprawdzić, czy PDF wymaga OCR?
Spróbuj zaznaczyć wiersz. Jeśli da się zaznaczyć słowa, plik ma już tekst i nie potrzebuje OCR. Jeśli się nie da albo cała strona zaznacza się jako jeden obraz, masz do czynienia ze skanem.
Kompresować przed OCR czy po nim?
Po. Wcześniejsza kompresja rozmywa obraz i obniża dokładność OCR. Uruchom OCR na oryginale, a jeśli plik jest ciężki, skompresuj go dopiero potem.
Jak nazywa się gotowy plik?
Tak jak Twój plik, z dopiskiem -ocr, więc `pismo.pdf` staje się `pismo-ocr.pdf`.
Czy moje pliki są przechowywane na serwerze?
Są usuwane po 2 godzinach, a możesz je też usunąć samodzielnie od razu po otrzymaniu wyniku.
Wypróbuj na swoim pliku
Bezpłatnie, bez rejestracji. Pliki są usuwane po 2 godzinach.