Un PDF scansionato non è altro che una serie di fotografie di pagine di carta. Tu vedi le parole, il computer no: Ctrl+F non trova nulla e non riesci a selezionare nemmeno una riga. L'OCR, il riconoscimento ottico dei caratteri, legge l'immagine, individua ogni carattere e sovrappone a ogni pagina un livello di testo nascosto.
OCR PDF
Trascina qui un PDF
PDF · fino a 100 MB per file
I file vengono eliminati dopo 2 ore. Puoi cancellarli subito dopo il download.
Cosa aggiunge l'OCR al tuo file
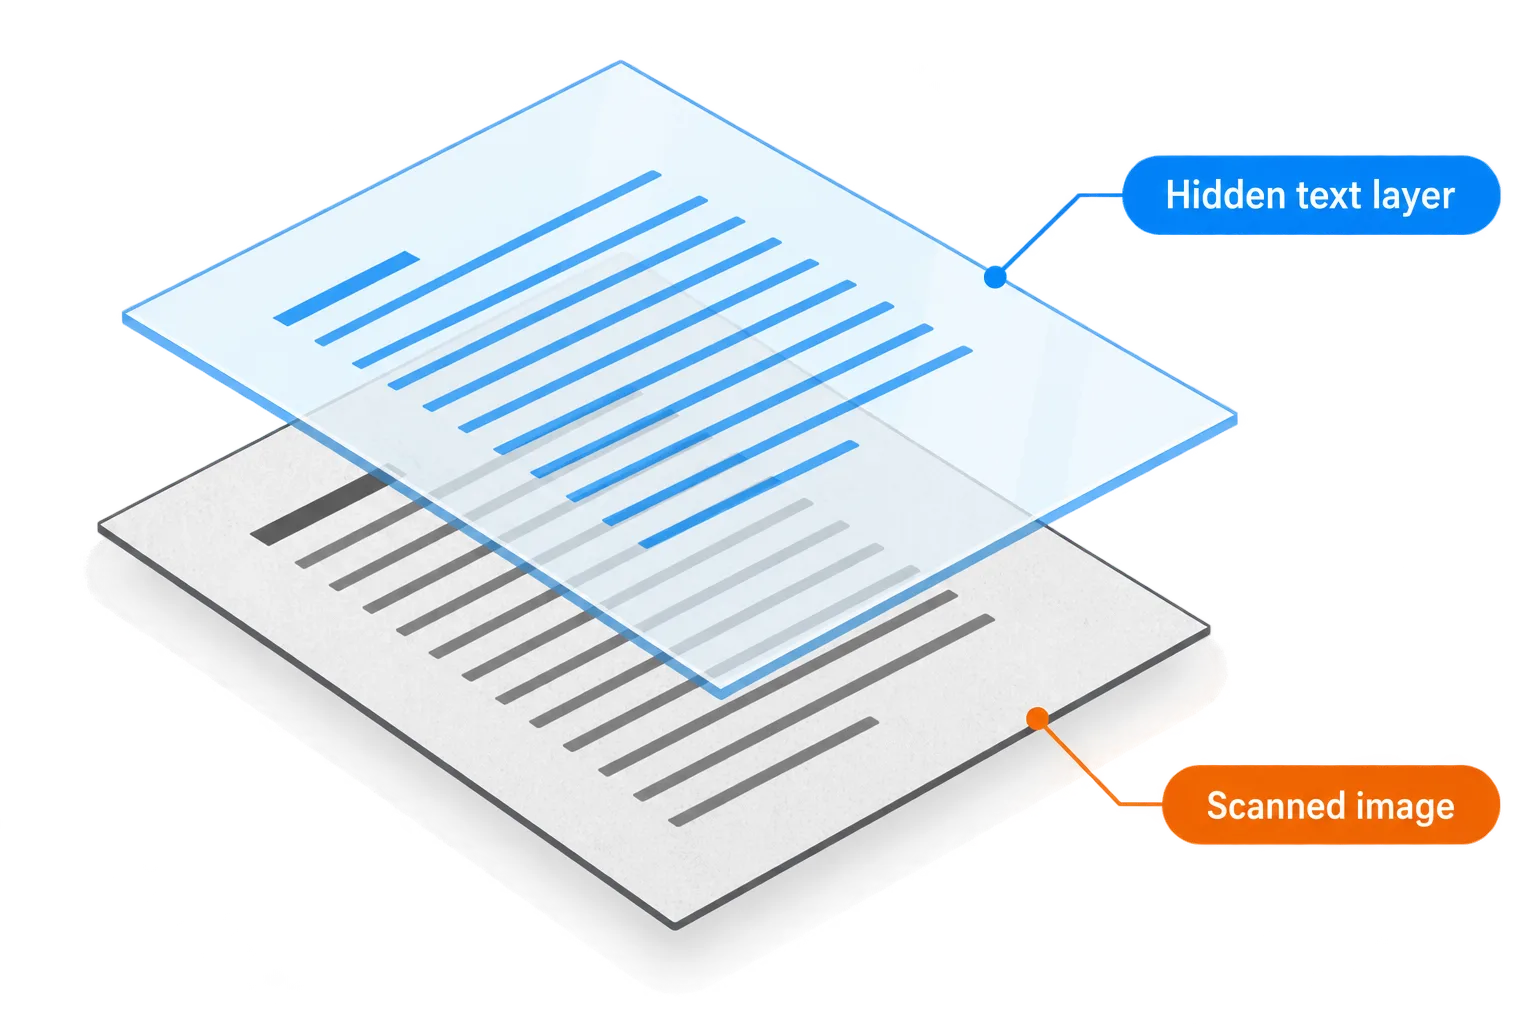
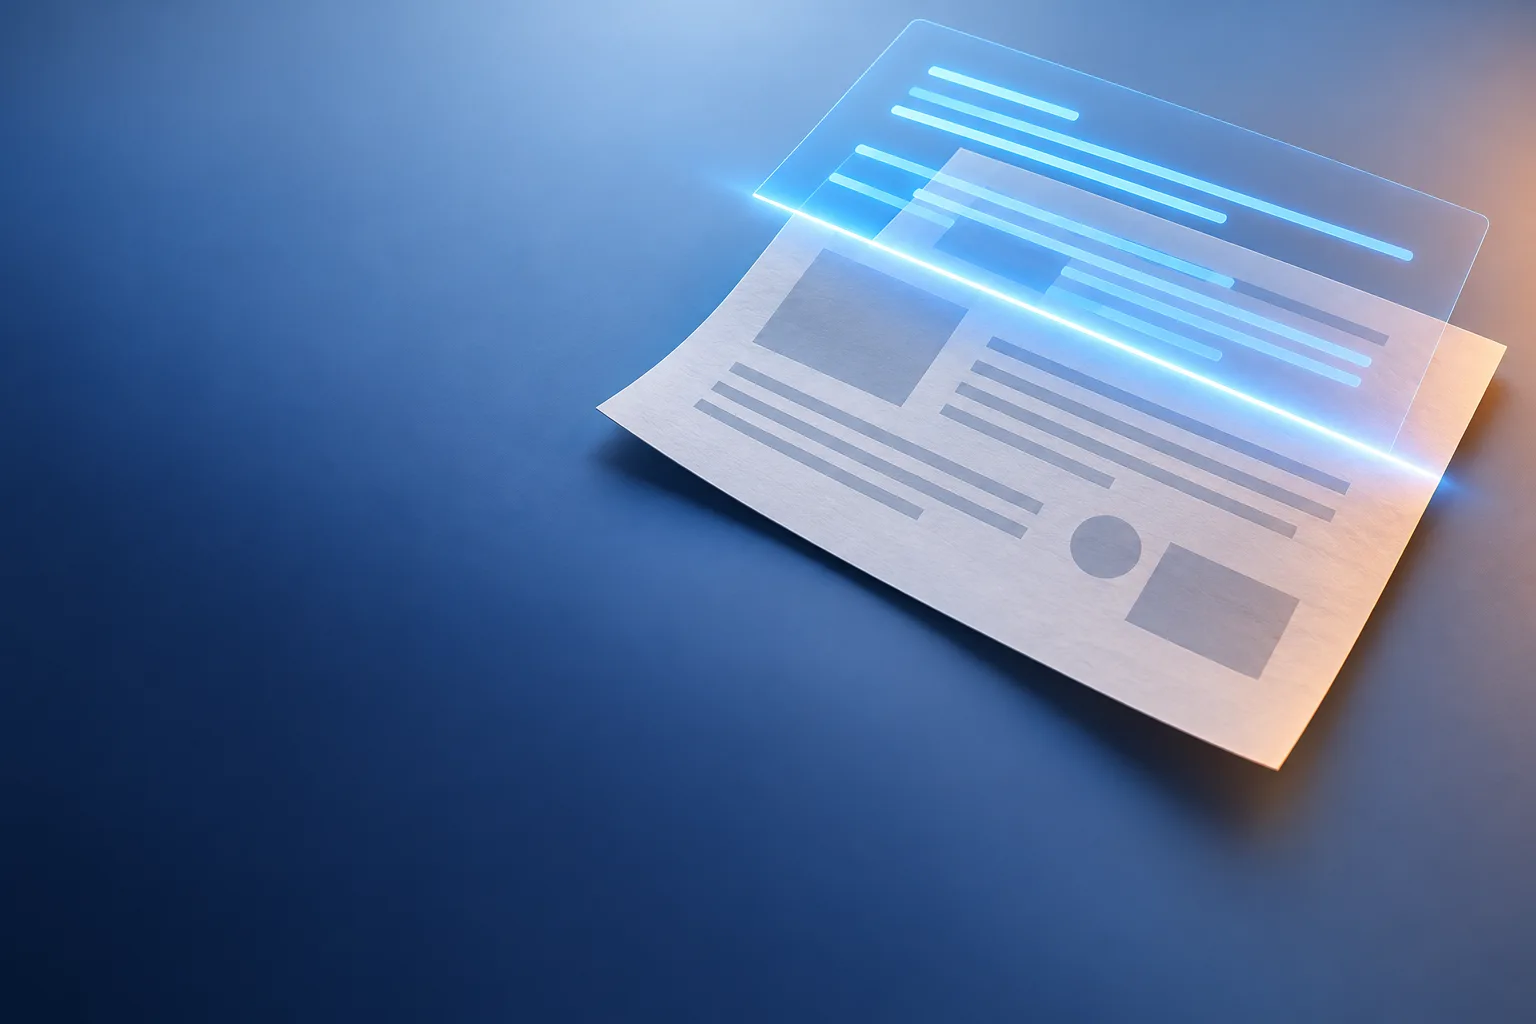
L'immagine della pagina resta com'è; un livello di testo trasparente si posa su ogni parola.
Dopo l'OCR una pagina ha esattamente lo stesso aspetto della scansione, perché l'immagine originale resta al suo posto. La novità è un livello di testo trasparente, allineato sopra ogni parola dell'immagine. È questo livello che cerchi, selezioni e copi, mentre in stampa continui a ottenere la pagina originale.
È anche il motivo per cui gli errori dell'OCR sono difficili da notare: l'immagine mostra la parola giusta, mentre il livello di testo nascosto potrebbe dire tutt'altro.
Come scansionare perché il testo venga letto bene
| Fattore | Punta a | Evita |
|---|---|---|
| Risoluzione | 300 DPI per un testo di dimensioni normali | Meno di 200 DPI, dove segni piccoli e accenti spariscono |
| Allineamento | Una pagina dritta con righe orizzontali | Pagine storte, righe che si incurvano vicino alla rilegatura di un libro |
| Luce | Uniforme e intensa, testo scuro su bianco | Ombre, riflessi, carta molto scura o ingiallita |
| Colore | Vanno bene sia la scala di grigi sia il colore | Una compressione pesante prima dell'OCR |
Accenti, punti e virgole sono alti solo pochi pixel. A bassa risoluzione una “e” e una “c”, o un “5” e una “S”, cominciano ad assomigliarsi, e i segni diacritici di lingue come il vietnamita semplicemente scompaiono. Se vuoi un OCR preciso, la risoluzione è la cosa su cui conviene investire.
Va bene anche il telefono: appoggia il foglio in piano e scatta dritto dall'alto vicino a una finestra. Unisci le foto con Immagine in PDF, poi premi Continua e scegli OCR PDF.
Scegli la lingua giusta
L'opzione predefinita è Entrambe, cioè vietnamita e inglese, adatta ai documenti bilingui come i contratti. Se il documento usa una sola lingua, sceglila: il motore dovrà indovinare all'interno di un solo alfabeto e confonderà meno caratteri.
Controlla il livello di testo dopo l'OCR
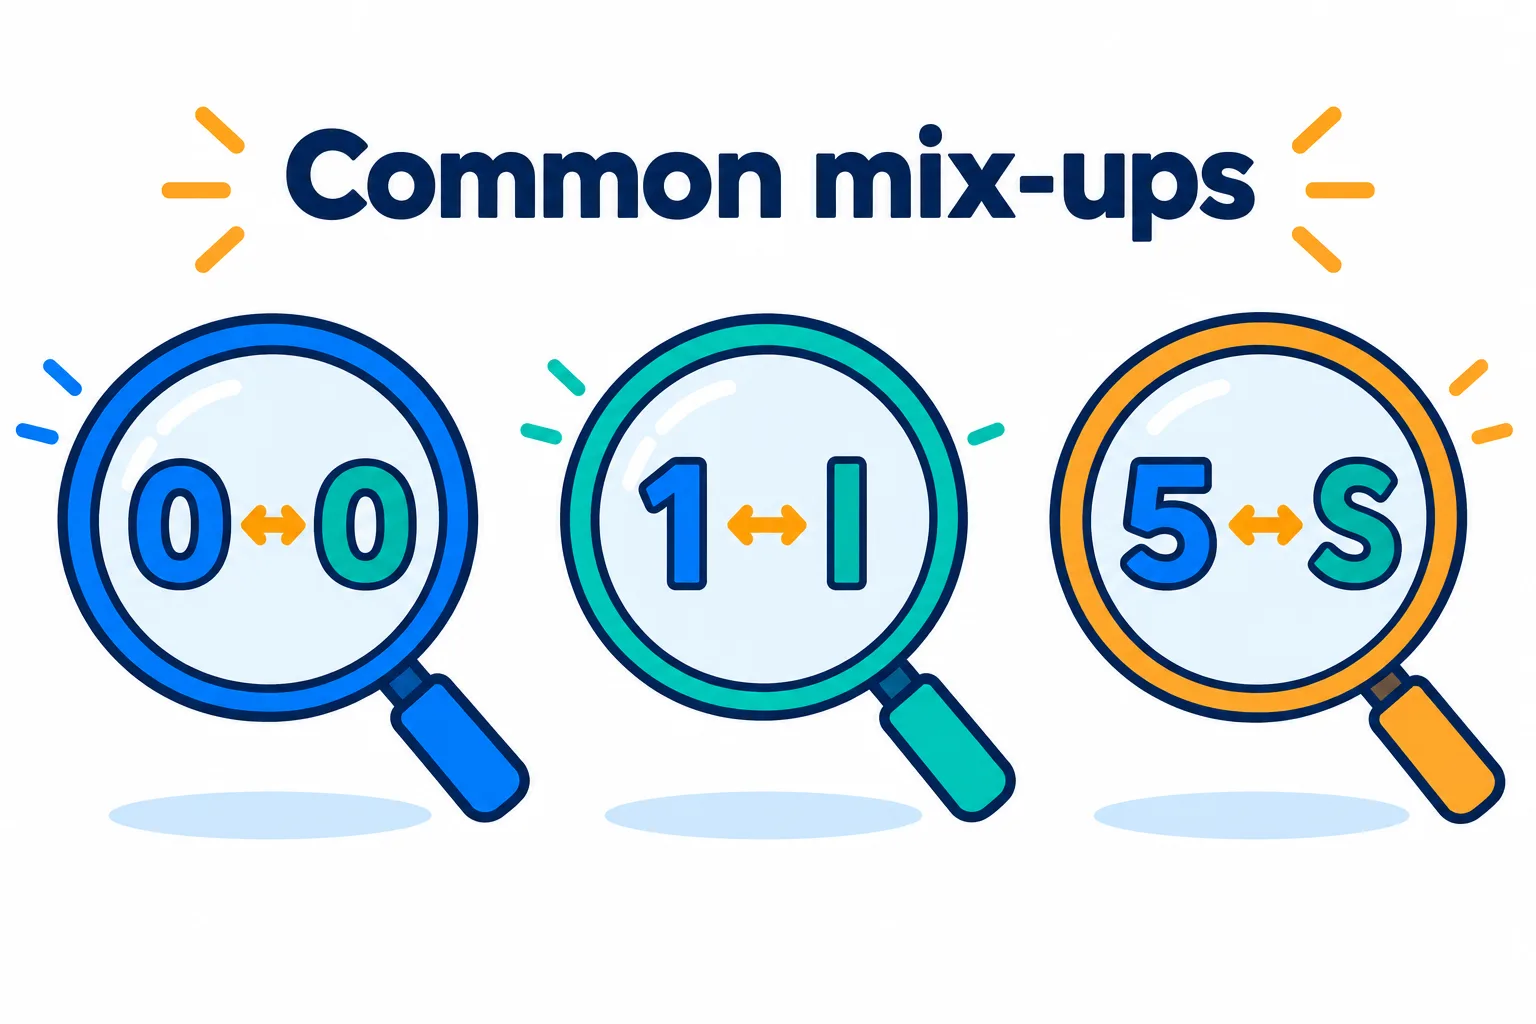
Queste coppie si assomigliano, quindi controlla i numeri a parte.
Passaggi
Premi Ctrl+F e cerca una parola che compare più volte. Se vengono trovate tutte le occorrenze, il livello di testo è in buone condizioni.
Seleziona un paragrafo e incollalo in un editor di testo semplice per vedere cosa dice davvero il livello.
Controlla i numeri a parte
0 e O, 1 e l, 5 e S sono gli scambi più frequenti.
Per modificare il contenuto, premi Continua e scegli PDF in Word.
Scritte a mano, timbri e firme vengono spesso letti male o saltati. Controlla a occhio importi, numeri di contratto e date prima di fidarti.
Se in realtà ti serve un file Word modificabile, leggi come convertire un PDF in Word.
Domande frequenti
Come faccio a sapere se un PDF ha bisogno dell'OCR?
Prova a selezionare una riga. Se riesci a selezionare le parole, il file contiene già del testo e l'OCR non serve. Se non ci riesci, o se l'intera pagina si seleziona come un'unica immagine, è una scansione.
Conviene comprimere prima o dopo l'OCR?
Dopo. Comprimere prima rende l'immagine meno nitida e l'OCR meno preciso. Esegui l'OCR sull'originale, poi comprimi se il file è pesante.
Come si chiama il risultato?
Il nome del tuo file con l'aggiunta di -ocr, quindi `lettera.pdf` diventa `lettera-ocr.pdf`.
I miei file restano sul server?
Vengono eliminati dopo 2 ore, e puoi cancellarli tu stesso non appena hai il risultato.
Provalo sul tuo file
Gratis, senza registrazione. I file vengono eliminati dopo 2 ore.