Plik PDF nie przechowuje akapitów. Zapisuje instrukcje w rodzaju „narysuj ten tekst w punkcie x, y, rozmiar 11 punktów, czcionka Times”. Konwersja na format Word polega na odczytaniu tysięcy takich instrukcji i wywnioskowaniu, które z nich tworzą akapit, nagłówek lub komórkę tabeli.
Dlatego ten sam konwerter może dać zupełnie inne wyniki dla dwóch różnych plików. Dobra wiadomość jest taka, że możesz przewidzieć rezultat, po prostu patrząc na swój dokument.
PDF na Word
Przeciągnij plik PDF tutaj
PDF · do 100 MB na plik
Pliki są usuwane po 2 godzinach. Możesz je usunąć od razu po pobraniu.
Co konwertuje się dobrze, a co traci układ
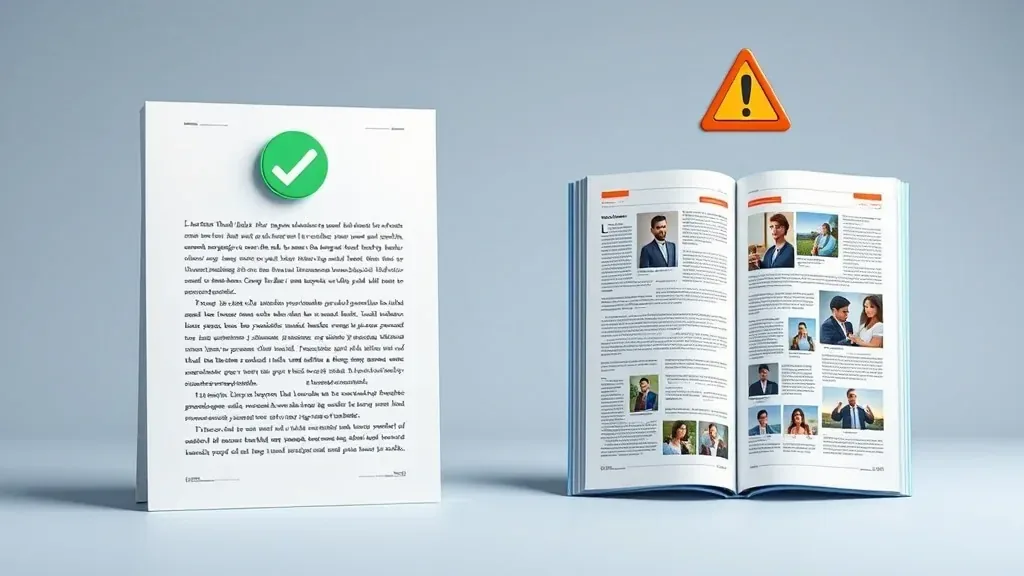
Dokumenty jednokolumnowe konwertują się dobrze. Strony wielokolumnowe z grafikami wstawionymi w tekst często tracą układ.
| Zazwyczaj konwertuje się dobrze | Zazwyczaj traci układ |
|---|---|
| Pliki PDF wyeksportowane bezpośrednio z Worda, Google Docs lub LibreOffice | Skany i zdjęcia dokumentów |
| Jednokolumnowe dokumenty oparte głównie na tekście | Magazyny i broszury ze zdjęciami wplecionymi w kolumny |
| Tabele z pełnymi liniami obramowania | Tabele wyrównane spacjami lub tabulatorami zamiast linii |
| Pliki z osadzonymi czcionkami | Pliki bez osadzonych czcionek |
Jeśli Twój plik pasuje do lewej kolumny, po prostu go przekonwertuj. Jeśli znajduje się w prawej kolumnie, przygotuj się na drobne poprawki lub wykonaj poniższe kroki.
Skany: najpierw uruchom OCR
OCR zamienia piksele na znaki. Dopiero wtedy można przekonwertować tekst do formatu Word.
Skan to w rzeczywistości zdjęcie każdej strony, więc nie zawiera tekstu, który można bezpośrednio wyodrębnić. OCR (optyczne rozpoznawanie znaków) odczytuje obraz i odtwarza tekst, aby dołączyć go do pliku.
Kroki
Sprawdź, czy plik zawiera prawdziwy tekst
spróbuj zaznaczyć linijkę. Jeśli się nie da, jest to obraz.
Jeśli to obraz, użyj najpierw narzędzia „OCR w PDF”, aby rozpoznać znaki i zapisać je w dokumencie.
Przekonwertuj rozpoznany plik na format Word.
W Wordzie włącz pokazywanie znaków formatowania, aby od razu zobaczyć, gdzie zamiast właściwego akapitu użyto ręcznego łamania wiersza.
OCR odgaduje znaki na podstawie pikseli, więc nigdy nie jest bezbłędny — szczególnie w przypadku znaków diakrytycznych, pisma odręcznego i słabych skanów. Sprawdź liczby i nazwy własne, zanim zaczniesz na nich polegać.
Szybkie poprawki w Wordzie po konwersji
- Nieprawidłowe lub uszkodzone czcionki: zaznacz cały tekst i zmień czcionkę na popularną, np. Arial lub Times New Roman.
- Każda linijka jako osobny akapit: użyj funkcji „Znajdź i zamień”, aby połączyć wiersze w pełne akapity.
- Przesuwające się obrazy: ustaw opcję opływania obrazu „Równo z tekstem”, aby ustabilizować układ.
Potrzebujesz formatu innego niż Word? Zobacz krótki przewodnik po wyborze formatu docelowego PDF.
Częste pytania
Każda linijka tekstu stała się osobnym akapitem.
Oznacza to, że plik PDF nie zawiera informacji o strukturze akapitów, co jest częste w plikach eksportowanych z programów do składu tekstu. Użyj funkcji „Znajdź i zamień” w Wordzie, aby je połączyć.
Czy jakiekolwiek narzędzie zachowuje układ w 100% idealnie?
Nie, a obietnice idealnego odwzorowania są przesadzone. Jeśli układ strony jest ważniejszy niż edycja treści, najlepiej zachować plik PDF i edytować go bezpośrednio.
Czy plik wynikowy ma format .doc czy .docx?
`.docx`. Otworzysz go w programie Word 2007 i nowszych, Google Docs oraz LibreOffice.
Czy moje pliki są przechowywane na serwerze?
Są usuwane po 2 godzinach, ale możesz też usunąć je samodzielnie od razu po pobraniu wyniku.
Wypróbuj na swoim pliku
Bezpłatnie, bez rejestracji. Pliki są usuwane po 2 godzinach.